Number Resource Society
Quand le routage tombe en panne, toute l’activité peut devenir inaccessible
Comprendre les fuites, détournements, erreurs de ROA et incohérences de registre ; diagnostiquer, rétablir le service et protéger la continuité sans transformer les litiges en coupures.
Sur cette page
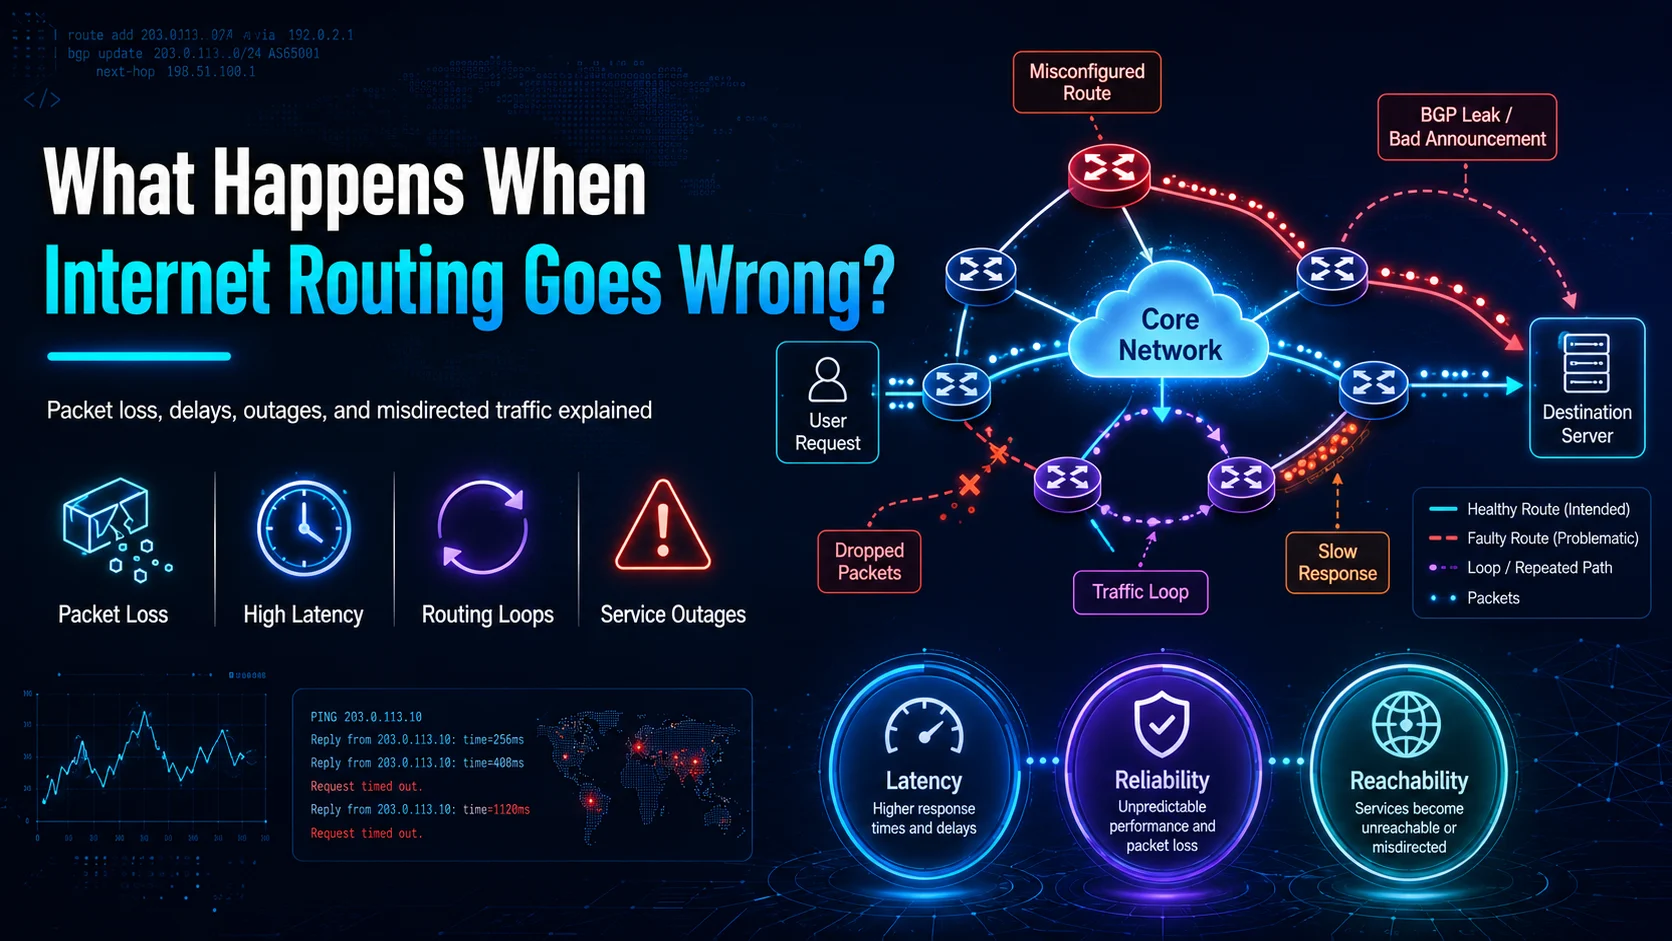
Les symptômes d’une panne de routage : pertes de paquets, latence élevée, boucles de routage et interruptions. Le schéma montre des symptômes, pas un incident précis ni une spécification de protocole.
Ouvrir un site, appeler une API ou joindre une application cloud paraît immédiat. Pourtant, la requête peut traverser plusieurs réseaux exploités indépendamment. BGP, le protocole de routage interdomaines, leur permet d’échanger les informations nécessaires pour trouver une destination.
Quand ce mécanisme se dérègle, un préfixe disparaît, le trafic emprunte un mauvais chemin ou un ASN non autorisé annonce un bloc. Un changement de réseau peut aussi laisser une ROA en décalage avec l’exploitation. Dans les cas complexes, routes, autorisations, registre et procédures institutionnelles racontent des histoires différentes.
Pour les FAI, opérateurs télécoms, hébergeurs, centres de données, plateformes cloud et entreprises, l’enjeu dépasse la technique : c’est la continuité de l’activité. Il faut donc penser ensemble routage, ressources numériques, RPKI, exactitude des registres, contrôle opérationnel, portabilité et reprise.
Comment Internet choisit ses chemins
Internet rassemble des réseaux autonomes qui acceptent d’échanger du trafic. FAI, opérateurs, universités, grandes entreprises, réseaux de contenus, clouds, hébergeurs et centres de données peuvent exploiter un système autonome identifié par un ASN.
Avec BGP, chacun indique à ses voisins qu’un préfixe est accessible par un chemin donné. Ces annonces se propagent ; chaque réseau sélectionne ses routes selon les attributs BGP et sa propre politique. Aucun routeur central ne dirige tous les paquets du monde.
Cette décentralisation permet le passage à l’échelle. Elle exige aussi que les réseaux évaluent les informations reçues : une erreur acceptée puis retransmise peut se propager très loin.
Reconnaître un problème de routage
Un service inaccessible, des applications coupées, une hausse de latence, des pertes de paquets ou un accès possible depuis certains pays seulement peuvent signaler un problème de route. D’autres indices sont plus directs : disparition du préfixe, origine ASN inattendue, chemin inhabituel ou route légitime devenue RPKI Invalid.
L’origine peut être une erreur, une attaque, des données incohérentes ou une décision administrative qui ne correspond plus au réseau réel. Identifier la bonne couche évite de réparer le serveur sans rétablir l’accès.
Une fuite de routes dépasse le périmètre prévu
Un réseau apprend une route auprès d’un fournisseur, puis la réannonce par erreur à un autre. Si celui-ci la propage, du trafic peut passer par un réseau qui n’était pas censé assurer ce transit.
Une telle fuite ne suppose pas forcément un attaquant. Une mauvaise politique d’export peut suffire à provoquer congestion, latence, pertes, coupures partielles ou problèmes de joignabilité à grande échelle. Politiques BGP, filtrage et maîtrise des changements sont essentiels.
Le détournement d’une annonce
Lorsqu’un réseau annonce un préfixe sans autorisation légitime et que d’autres acceptent cette annonce, le trafic peut être attiré vers le mauvais système autonome. Cela peut entraîner interruption, redirection, perte de connectivité, risque d’interception, alertes de sécurité et perturbations pour les clients.
BGP ne demandait pas à l’origine une preuve cryptographique pour chaque annonce. RPKI répond à une partie de cette limite. Une annonce visible, une inscription au registre et un contrôle opérationnel légitime restent toutefois trois faits distincts : aucun ne remplace à lui seul les autres.
Une erreur ordinaire peut avoir un impact considérable
Mauvais préfixe, annonce oubliée, filtre incorrect, ASN erroné, retrait accidentel, local preference inadéquate, sous-préfixe imprévu ou migration sans mise à jour du routage : les erreurs simples peuvent toucher des milliers de clients.
Traitez toute modification de route comme un changement de production. Il faut savoir quels préfixes doivent être annoncés et quel ASN est autorisé à les annoncer.
Des ROA cohérentes avec l’exploitation
RPKI fournit des informations vérifiables cryptographiquement. Une ROA désigne l’ASN autorisé, les préfixes concernés et, éventuellement, leur longueur maximale. La validation d’origine compare les annonces BGP aux données issues des ROA validées.
Une route est Valid si au moins une autorisation couvrante correspond à son ASN et à sa longueur. Elle est Invalid si des autorisations la couvrent sans qu’aucune corresponde, et Not Found si aucune ne la couvre. Ces états alimentent la politique locale ; ils ne certifient pas le chemin complet.
Après un changement d’ASN, une ROA restée sur l’ancienne origine peut rendre Invalid une route pourtant légitime. Même problème si une annonce plus spécifique dépasse maxLength. L’autorisation doit suivre les changements opérationnels vérifiés.
La sécurité ne doit pas devenir un instrument de pression
Pour NRS, RPKI doit protéger l’intégrité du routage, pas servir de moyen général de sanction dans des litiges commerciaux, institutionnels, d’adhésion ou de politique.
Un désaccord sur la location, la localisation des clients, l’usage commercial, la structure d’une entreprise ou une règle de registre n’est pas automatiquement un incident de sécurité du routage. Tant que l’exploitation reste légitime, les assertions de sécurité doivent rester liées à la validité technique et au contrôle reconnu.
Les utiliser comme levier dans un différend sans rapport transforme une protection en risque pour la continuité. Une divergence de politique ne devrait pas être punie par une coupure.
La validation d’origine ne sécurise pas tout le trajet
ROV vérifie l’autorisation de l’ASN d’origine, pas chaque maillon de l’AS path. Elle ne supprime à elle seule ni les fuites, ni toutes les manipulations de chemin, ni les erreurs internes, les pannes d’amont, les coupures physiques ou les mauvaises politiques.
Elle doit compléter le filtrage, l’IRR, la surveillance BGP, la gestion des politiques, l’exactitude des registres et le contrôle des changements.
Des objets IRR périmés peuvent bloquer des routes légitimes
Les registres de routage Internet contiennent des informations utilisées pour construire des filtres. Un fournisseur peut ainsi consulter un objet route pour déterminer les annonces attendues d’un client.
Un nouvel ASN, un changement d’opérateur, un ancien objet conservé ou un nouvel objet oublié peuvent rendre le filtre trop restrictif ou insuffisant. Une architecture modifiée exige une mise à jour de ses données : les informations de routage font partie de l’infrastructure opérationnelle.
Des coordonnées exactes accélèrent la résolution
WHOIS et RDAP ne transportent pas les paquets. Ils aident à retrouver l’organisation associée au préfixe, les contacts, le registre responsable et les changements d’organisation, puis à rapprocher ces données de l’origine ASN attendue.
Un contact erroné ne provoque pas nécessairement la panne, mais peut la prolonger. Maintenir les données de ressources ne relève donc pas d’une simple formalité.
Le registre décrit la réalité, il ne la remplace pas
L’unicité des ressources exige des registres fiables : relations, contacts, statut, transferts, assertions de sécurité et litiges. Mais ce sont les routeurs qui échangent les routes, les opérateurs qui entretiennent l’infrastructure et les clients qui utilisent les services.
NRS propose de raisonner ainsi : réseau en fonctionnement, contrôle opérationnel, autorisation de routage, puis enregistrement. Ces couches doivent concorder ; lorsqu’elles divergent, il faut les réconcilier sans détruire le service.
C’est un principe de continuité, pas une règle de protocole. Une annonce BGP visible ne prouve pas, à elle seule, un droit légitime : il faut rapprocher preuves d’exploitation, autorisations, registres et droits applicables.
Préserver le service pendant un différend
Un bloc IPv4 peut déjà porter des clients, applications, entrées DNS et listes d’autorisation. Son ASN continue de l’annoncer alors qu’un litige administratif apparaît. Réseau actif, enregistrement contesté, autorisation en cours d’examen et prétentions contractuelles opposées peuvent alors coexister.
NRS défend le maintien du dernier état opérationnel légitime vérifié pendant une résolution indépendante du différend. Modifier une base ne doit pas être considéré comme effaçant toutes les autres réalités.
Il faut préserver routes, clients, assertions de sécurité, DNS direct et inverse, historique et preuves, ainsi qu’une voie neutre de règlement. La continuité ne doit pas devenir un dommage collatéral.
Enregistrer, autoriser, annoncer et accepter sont quatre fonctions
Être inscrit comme titulaire ne rend pas le bloc joignable : il faut encore l’annoncer et que d’autres réseaux acceptent la route. Pouvoir techniquement l’annoncer ne suffit pas non plus à établir la légitimité de son usage.
Qui figure au registre ? Qui exerce le contrôle ? Quel ASN est autorisé, lequel annonce réellement, et qui accepte ? Ingénierie réseau, administration des ressources et sécurité doivent répondre ensemble, sans cloisonner routage, registre et RPKI.
Des serveurs sains, des clients déconnectés
Les clients voient un site indisponible, un accès qui fonctionne dans un pays et pas dans un autre, ou un mobile connecté quand le haut débit fixe échoue. Ils ne voient pas les messages BGP.
Les réseaux peuvent sélectionner des chemins différents, suivre une mauvaise annonce ou la rejeter. Une supervision applicative au vert ne prouve donc pas la joignabilité externe. Pour le client, le service reste indisponible quelle que soit la couche en cause.
Une panne de routage devient vite une crise d’activité
L’incident dépasse rapidement l’équipe réseau : recettes, assistance, engagements, confiance et coordination sont concernés.
Recettes
SaaS, cloud, hébergement, fintech, commerce en ligne, FAI et jeux dépendent de clients capables de les joindre. L’inaccessibilité peut interrompre les transactions même si les systèmes internes continuent de fonctionner.
Assistance
Les tickets peuvent affluer alors que les serveurs sont sains. Le support doit connaître le périmètre réel de la panne.
Engagements de service
Une coupure de routage peut constituer un incident au regard du SLA, même sans défaillance interne.
Confiance
Le client distingue rarement une panne de serveur d’une panne de route. Il retient l’indisponibilité.
Coût de résolution
Il peut falloir réunir ingénieurs, transitaires, opérateurs externes, sécurité, administrateurs du registre et du RPKI, support et direction. Les ressources numériques doivent donc figurer dans le plan global de continuité.
Vérifier si le routage est en cause
Ne concluez pas d’emblée à une panne applicative. Reconstituez la visibilité, l’origine, l’état de validation et les changements récents.
Le préfixe est-il encore visible ?
Consultez plusieurs vues du routage mondial. Une disparition impose de vérifier l’annonce BGP et les retraits.
Quel ASN annonce le préfixe ?
Comparez l’origine observée à celle attendue. Un écart peut venir d’une erreur, d’une migration incomplète, d’un détournement ou d’une autorisation périmée.
Quel est l’état RPKI ?
Relevez Valid, Invalid ou Not Found. Un passage à Invalid après un changement légitime justifie de vérifier la ROA ; ce n’est pas, à lui seul, la preuve d’une attaque.
Des routes plus spécifiques sont-elles apparues ?
Un sous-préfixe peut attirer le trafic d’un agrégat. Examinez aussi les annonces contenues dans le préfixe attendu.
Qu’est-ce qui a changé ?
Reconstituez les modifications de routeur, fournisseur, ASN, RPKI, filtres, infrastructure et registre. Leur chronologie aide à trouver la cause.
Les données correspondent-elles à la production ?
Confrontez registre et IRR à l’état opérationnel vérifié, au lieu de consulter une seule couche.
Huit étapes pour rétablir la continuité
Une réponse structurée part de l’état attendu, confronte les observations, vérifie autorisations et filtres, puis corrige et surveille.
1. Établir l’état attendu
Documentez préfixe, ASN d’origine, fournisseur amont, annonce prévue, ROA actuelle et objet IRR. Sans référence, on identifie mal les écarts.
2. Comparer plusieurs points de vue
Un routeur local ne suffit pas. Des observations dans plusieurs réseaux et régions permettent de distinguer un problème local, amont, régional ou largement propagé.
3. Vérifier RPKI
Contrôlez préfixe, ASN, longueur maximale, validité du certificat et validation de l’objet signé. Après une modification d’architecture, vérifiez aussi que la ROA a suivi.
La ROA ne possède pas de champ autonome de « période d’autorisation ». L’expiration ou la révocation d’un certificat peut invalider l’objet ; l’état de la route dépend ensuite des données validées restantes. La perte d’une ROA ne signifie donc pas automatiquement Invalid.
4. Vérifier IRR et filtres
Les filtres amont doivent correspondre aux annonces légitimes attendues du client, notamment après une migration.
5. Contacter le bon réseau avec des faits précis
Transmettez préfixe, ASN attendu et observé, état RPKI, heure de l’incident et éléments de routage. Ces informations sont plus utiles qu’un signalement vague.
6. Corriger à la source
Si l’erreur vient de votre réseau, corrigez sa configuration puis vérifiez la propagation de la bonne annonce.
7. Protéger la continuité en cas de litige
Conservez le dernier état vérifié, les données de sécurité, l’historique du registre, les preuves et le service client. Résoudre un différend de contrôle ne justifie pas de déstabiliser inutilement la production.
8. Suivre le rétablissement
Les changements ne sont pas visibles partout simultanément. Continuez jusqu’au retour de la route attendue et à la stabilisation de l’accès client.
Réduire la probabilité et l’impact
Aucun réseau ne peut exclure tout incident. Une maintenance coordonnée des autorisations, filtres, données et observations en réduit le risque.
Tenir les ROA à jour
Réexaminez-les lors d’un changement d’origine ASN, de fournisseur, de longueur de préfixe ou d’architecture.
Intégrer la validation d’origine
Les réseaux récepteurs peuvent utiliser ROV dans leur politique BGP. Établir un état et décider d’accepter une route sont deux opérations distinctes.
Entretenir les objets IRR
Les informations doivent correspondre aux annonces légitimes prévues ; nouveaux objets et anciens objets font partie du même changement.
Encadrer les annonces des voisins
Un voisin BGP ne doit pas pouvoir annoncer n’importe quoi par défaut. Le filtrage limite la diffusion des erreurs.
Détecter les changements
Surveillez disparition du préfixe, nouvel ASN, sous-préfixes inattendus, état RPKI et AS path inhabituel. Détecter tôt raccourcit les incidents.
Maintenir les coordonnées et les registres
Organisation, contacts et ressources doivent rester à jour pour que l’on puisse joindre les bons responsables.
Auditer l’ensemble des dépendances
Couvrez IPv4, IPv6, ASN, annonces BGP, RPKI, IRR, accès aux registres, contacts, contrats et dépendances réseau.
Prévoir une sortie au niveau de la ressource
NRS défend un système où un réseau actif ne dépend pas à jamais d’un seul gardien institutionnel. Panne, insolvabilité, indisponibilité technique, conflit de gouvernance, empêchement juridique ou perte de confiance doivent laisser une voie de continuité.
La portabilité d’une ressource ne signifie pas déménager toute l’entreprise. Elle vise à changer de prestataire administratif tout en préservant preuve de contrôle, enregistrements, DNS inverse, RPKI, routes et historique d’audit.
Cette portabilité et la relève des fonctions de registre sont des propositions de résilience. Leur disponibilité dépend des mécanismes applicables ; cet article ne promet pas qu’un transfert ou une relève soit possible pour toute ressource aujourd’hui. Sans sortie, l’échec d’une institution devient celui du réseau.
La fonction de registre doit survivre à son opérateur
Une infrastructure critique ne devrait pas dépendre entièrement de la survie d’une société. Sa reprise doit prévoir état du registre, sauvegardes, historique, WHOIS/RDAP, DNS inverse, dépôts RPKI, moyens d’authentification, transferts, métadonnées de litiges et administration de remplacement.
Protéger cette fonction ne revient pas à préserver chaque conseil d’administration, règle, interprétation contractuelle ou pouvoir de l’institution en place. Il faut préserver les fonctions techniques dont Internet a besoin.
Protéger le registre, pas un pouvoir sans limite
Unicité des adresses, exactitude des données, disponibilité des assertions de sécurité et traçabilité des litiges exigent une coordination fiable. L’organisme chargé de tenir les comptes ne se confond pourtant pas avec les comptes eux-mêmes.
En cas de défaillance, priorité au registre, à la chaîne de sécurité, aux routes, aux clients et au réseau actif. Plus la coordination est critique, plus son opérateur doit être auditable, remplaçable et résilient, et les ressources portables.
Donner la priorité au réseau qui fonctionne
Le principe de « Running-Code Primacy » défendu par NRS limite la couche commune de coordination aux besoins réels d’interopérabilité : unicité, données exactes, preuve de contrôle, assertions de sécurité, transferts, conflits et continuité.
Cela ne confère pas automatiquement au registre le contrôle des modèles commerciaux, de la géographie des clients, de la location, du financement d’actifs, de la stratégie ou de tous les usages futurs. Contrats, droit, marchés et autres mécanismes appropriés peuvent traiter ces questions.
Sans menace technique réelle pour l’unicité ou l’interopérabilité, ces désaccords ne devraient pas provoquer de panne de routage. Une mission de registre clairement délimitée renforce la résilience.
La stabilité doit se mesurer à la joignabilité
Une institution peut garder ses bureaux ouverts alors que ses clients sont hors ligne. Inversement, un conflit de gouvernance ne signifie pas forcément que les réseaux ont cessé de fonctionner.
Les bonnes questions sont concrètes : les réseaux légitimes peuvent-ils continuer ? Les clients restent-ils joignables ? Les routes et assertions valides restent-elles disponibles ? Peut-on régler les litiges sans détruire la production ? Voilà la continuité que la gouvernance doit protéger.
Préparer un plan pour les ressources numériques
On prépare la continuité de l’électricité, des centres de données, du cloud, du transit, du matériel, du personnel et de la cybersécurité. Il faut en faire autant pour les numéros.
Que faire si un préfixe disparaît ? Qui modifie les ROA et détient les accès RIR ? Quel ASN annonce chaque bloc ? Quels clients ont des adresses fixes et quelles applications dépendent des plages ? Qui contacte l’amont ? Quelles preuves établissent le contrôle ? Que faire si le registre devient indisponible, si une relève est nécessaire ou si un litige survient ?
IP et ASN font partie de l’infrastructure métier
Clients, API, DNS, pare-feu, VPN, listes d’autorisation partenaires, cloud, sécurité, paiements, supervision et documentation de conformité peuvent dépendre des identifiants réseau.
Serveurs sains, application active et alimentation disponible ne suffisent pas si le préfixe n’est plus correctement routé. Les ressources numériques ont leur place dans la continuité de l’entreprise.
L’objectif est la continuité d’Internet
Erreurs BGP, fuites, détournements, filtres incorrects, ROA ou IRR périmés, registre inexact et divergence administrative peuvent tous rendre un service inaccessible.
La protection dépasse les routeurs : réseau actif, ressources, autorisations, registre, sécurité et contrôle doivent rester cohérents. Les registres préservent l’unicité, RPKI protège le routage, les litiges sont traités séparément, la portabilité offre une sortie et la relève maintient les fonctions critiques.
Il ne s’agit pas de rendre une institution immortelle, mais de maintenir Internet en fonctionnement. Protéger clients, réseau, assertions et registre exige de distinguer le gardien de l’infrastructure qu’il doit servir.
Questions fréquentes
D’où viennent les problèmes de routage ?
Erreurs BGP, fuites, annonces non autorisées, mauvais filtres, erreurs RPKI ou ROA, problèmes amont et incohérences entre routes et registres sont des causes courantes.
Qu’est-ce qu’une fuite BGP ?
C’est la propagation d’informations de routage au-delà du périmètre prévu par la politique, avec le risque d’attirer le trafic vers un chemin non souhaité.
Qu’est-ce qu’un détournement BGP ?
Un ASN annonce un préfixe sans autorisation légitime. Si d’autres réseaux l’acceptent, le trafic peut être redirigé.
À quoi sert RPKI ?
À fournir des informations cryptographiquement vérifiables sur l’autorisation d’un ASN à annoncer un préfixe. ROV ne certifie pas le chemin complet.
Une mauvaise ROA peut-elle couper l’accès ?
Oui : une route légitime devient Invalid si des données validées la couvrent sans autoriser son origine et sa longueur. Certains réseaux peuvent alors la rejeter selon leur politique. L’expiration d’un certificat ou le rejet d’un objet ne suffit pas à déterminer l’état : les données validées restantes comptent.
Sources et précisions éditoriales
Publié le 11 août 2026 et mis à jour le 13 août, cet article a été révisé le 14 octobre 2026. La précision technique distingue validité du certificat et de l’objet signé, et état de validation de la route. Portabilité, continuité et relève du registre sont des propositions de NRS, sans garantie de disponibilité générale.
Intégrer les ressources à votre prochain examen de continuité
NRS Shield est l’endroit où les opérateurs transforment un risque individuel en force collective, et la procuration est le moyen de donner à NRS l’autorité d’agir pour votre réseau.