Number Resource Society
Cuando falla el enrutamiento, un negocio en marcha puede quedar incomunicado
Cómo diagnosticar fugas, secuestros, errores de ROA e incoherencias del registro, recuperar el acceso y evitar que una disputa institucional interrumpa el servicio.
En esta página
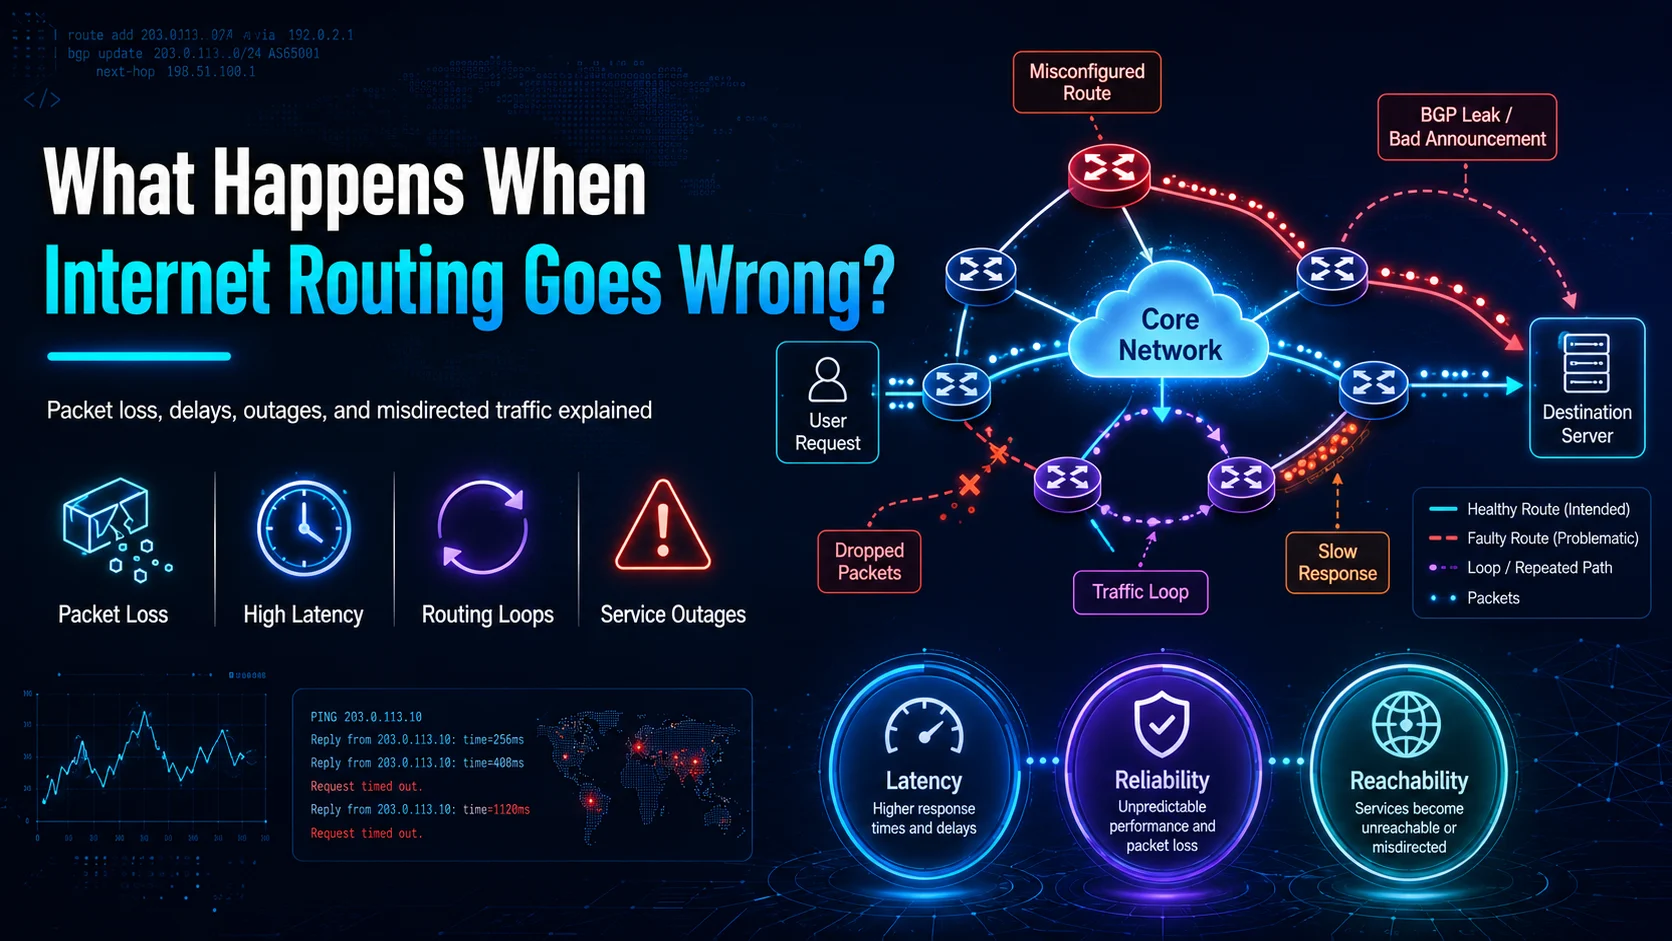
Los síntomas de un fallo de enrutamiento: pérdida de paquetes, latencia alta, bucles de enrutamiento y caídas. El esquema muestra síntomas, no un incidente concreto ni una especificación del protocolo.
Abrir una web, consultar una API o conectar una aplicación en la nube parece instantáneo. La petición, sin embargo, puede cruzar varias redes independientes. BGP, el protocolo de enrutamiento entre redes, permite intercambiar la información que hace posible ese recorrido.
Cuando algo falla, desaparece un prefijo, el tráfico sigue un camino equivocado o un ASN no autorizado anuncia un bloque. También puede cambiar la red y quedarse atrás su ROA. En los casos más complejos, el funcionamiento real, las autorizaciones, los registros y los procedimientos institucionales dejan de coincidir.
Para proveedores de Internet, operadores, empresas de alojamiento, centros de datos, plataformas cloud y otras empresas, esto compromete la continuidad del negocio. La resiliencia exige considerar juntos el enrutamiento, los recursos numéricos, RPKI, los registros, el control operativo, la portabilidad y los planes de continuidad.
Cómo encuentra Internet un camino
Internet reúne redes que operan de forma independiente y acuerdan intercambiar tráfico. Proveedores, universidades, grandes empresas, redes de contenidos, operadores, servicios cloud y centros de datos pueden gestionar sistemas autónomos identificados mediante un ASN.
Con BGP, una red comunica a sus vecinas que puede alcanzar un prefijo por determinada ruta. Las demás propagan esa información y eligen caminos según los atributos BGP y sus propias políticas. No existe un router central que decida el recorrido de todos los paquetes.
Esa descentralización permite operar a escala mundial, pero exige evaluar la información recibida. Un error aceptado y retransmitido puede extenderse por muchas redes.
Qué aspecto tiene un fallo de enrutamiento
Una web inaccesible, aplicaciones desconectadas, latencia elevada, pérdida de paquetes o acceso disponible solo desde algunas regiones son posibles síntomas. También pueden observarse un prefijo ausente, un ASN de origen inesperado, una ruta extraña o una ruta legítima clasificada como RPKI Invalid.
La causa puede ser accidental, maliciosa, una incoherencia técnica o un cambio administrativo ajeno al estado real de la red. Distinguir la capa afectada evita reparar la aplicación sin recuperar el acceso.
Fugas de rutas: anuncios que van más allá de lo previsto
Una red aprende una ruta de un proveedor y, por una política de exportación incorrecta, la anuncia a otro. Si este la acepta y propaga, el tráfico puede atravesar una red que no debía prestar ese tránsito.
No hace falta un atacante. Una configuración equivocada puede causar congestión, retrasos, pérdidas, interrupciones parciales o problemas de alcance generalizados. Las políticas BGP, los filtros y el control de cambios son fundamentales.
Secuestro de rutas: un origen sin autorización
Si una red anuncia un prefijo sin autorización legítima y otras aceptan el anuncio, el tráfico puede dirigirse al sistema autónomo equivocado. Puede haber interrupciones, redirección, pérdida de conectividad, riesgo de interceptación, alertas y perjuicios para los clientes.
BGP no exigía originalmente una prueba criptográfica para cada anuncio de origen. RPKI responde a parte de esa carencia. Pero un anuncio visible, una inscripción en el registro y el control operativo legítimo siguen siendo hechos diferentes; uno no demuestra por sí solo los otros.
Un error pequeño puede afectar a miles de clientes
Anunciar un prefijo incorrecto, omitirlo, usar filtros o ASN equivocados, retirar una ruta accidentalmente, configurar mal local preference, anunciar subprefijos imprevistos o no actualizar las rutas tras una migración puede provocar fallos graves.
Cada cambio de enrutamiento debe tratarse como un cambio de producción. Antes de ejecutarlo, hay que saber qué debe anunciarse y qué ASN tiene autorización para hacerlo.
Las ROA tienen que seguir los cambios de la red
RPKI aporta información verificable mediante criptografía. Una ROA identifica el ASN autorizado, los prefijos y, opcionalmente, la longitud máxima permitida. La validación del origen compara los anuncios BGP con los datos de las ROA validadas.
Valid significa que al menos una autorización que cubre la ruta coincide con el ASN y la longitud. Invalid significa que hay autorizaciones que la cubren, pero ninguna coincide. Not Found indica que no hay ninguna que la cubra. Estos estados informan la política local; no certifican todo el recorrido.
Una empresa puede migrar legítimamente a un ASN nuevo y conservar una ROA que solo admite el anterior. También puede anunciar un prefijo más específico de lo permitido por maxLength. En ambos casos, una ruta legítima puede resultar Invalid. La autorización debe acompañar a los cambios operativos verificados.
La seguridad no debe convertirse en una herramienta de presión
NRS sostiene que RPKI debe proteger la integridad del enrutamiento, sin convertirse en un mecanismo general de sanción para disputas comerciales, institucionales, de afiliación o de políticas.
Un desacuerdo sobre alquiler, ubicación de clientes, uso comercial, estructura empresarial o reglas del registro no constituye automáticamente un fallo de seguridad. Mientras la explotación siga siendo legítima, las declaraciones de seguridad deben vincularse a la validez técnica y al control reconocido.
Utilizarlas como presión en un conflicto ajeno puede transformar la propia seguridad en un riesgo de continuidad. Discrepar sobre una política no debería castigarse con una interrupción de red.
Validar el origen no equivale a validar toda la ruta
ROV comprueba si el ASN puede originar el prefijo, no cada elemento del AS path. Por sí sola no elimina las fugas, todas las manipulaciones del camino, errores internos, fallos de configuración del proveedor, averías físicas o políticas deficientes.
Debe combinarse con filtros de prefijos, IRR, vigilancia de BGP, gestión de políticas, registros exactos y control de cambios. Entender el papel de RPKI y de IRR permite utilizar ambos sin atribuirles funciones que no tienen.
Los objetos IRR desactualizados pueden bloquear tráfico legítimo
Los registros de enrutamiento contienen información con la que se construyen filtros. Un proveedor puede consultar un objeto route para determinar qué prefijos espera recibir de un cliente.
Cambiar de ASN u operador, dejar objetos antiguos, olvidar crear los nuevos o modificar la arquitectura sin actualizar los datos puede provocar rechazos indebidos o filtros insuficientes. Los registros de rutas forman parte de la infraestructura operativa.
Los datos correctos ayudan a resolver antes
WHOIS y RDAP no encaminan paquetes. Ayudan a identificar la organización asociada al prefijo, sus contactos, el registro responsable y los cambios organizativos, y a contrastarlo con otros datos, como el ASN de origen esperado.
Un contacto erróneo quizá no causó la caída, pero puede prolongarla. La información de los recursos debe mantenerse al día, no tratarse como un trámite que se olvida después de completarlo.
El registro describe una realidad, no la sustituye
La unicidad de los recursos requiere registros fiables de relaciones, contactos, estado, transferencias, seguridad y disputas. Sin embargo, son los routers los que intercambian rutas, los operadores quienes mantienen la infraestructura y los clientes quienes dependen de ella.
NRS propone partir de la red en funcionamiento, el control operativo, la autorización de enrutamiento y el registro. Esas capas deben concordar. Si divergen, el objetivo es reconciliarlas sin destruir el servicio.
Se trata de un principio de continuidad, no de una regla de protocolo. Ver un anuncio BGP no demuestra por sí solo un derecho legítimo: deben contrastarse pruebas operativas, autorizaciones, registros y derechos aplicables.
Mantener el servicio mientras se resuelve una disputa
Un bloque IPv4 puede sostener clientes, aplicaciones, DNS y listas de acceso. Su ASN sigue anunciándolo cuando surge una disputa administrativa. Pueden coexistir una red activa, registros cuestionados, autorizaciones bajo revisión y pretensiones contractuales incompatibles.
NRS defiende conservar el último estado operativo legítimo verificado mientras el conflicto se resuelve de forma independiente. Cambiar una base de datos no hace desaparecer todas las demás circunstancias.
Deben protegerse rutas, clientes, declaraciones de seguridad, DNS directo e inverso, historial y pruebas, junto con una vía neutral de resolución. La continuidad no debe ser un daño colateral.
Registrar, autorizar, anunciar y aceptar son funciones distintas
Figurar como titular no hace que un bloque sea accesible: alguien debe anunciarlo y otras redes aceptar la ruta. Poder anunciarlo técnicamente tampoco demuestra que toda su situación sea correcta.
Hay que distinguir quién figura en el registro, quién controla la operación, qué ASN está autorizado, cuál anuncia realmente y qué redes lo aceptan. Ingeniería, administración de recursos y seguridad deben trabajar juntas, sin aislar BGP, registro y RPKI.
Los servidores pueden estar sanos y los clientes sin acceso
El usuario ve una web caída, un país con acceso y otro sin él, o una conexión móvil que funciona cuando la fija falla. No ve los mensajes BGP.
Cada red puede elegir una ruta distinta, seguir un anuncio incorrecto o rechazarlo. Una monitorización de aplicaciones en verde no demuestra accesibilidad externa. Para el cliente, el resultado sigue siendo un servicio indisponible.
El incidente sale pronto del equipo de red
Los problemas de enrutamiento afectan a ingresos, soporte, compromisos, confianza y coordinación de la empresa.
Ingresos
SaaS, nube, alojamiento, fintech, comercio electrónico, ISP, videojuegos y otros servicios digitales pueden dejar de procesar transacciones cuando sus clientes no consiguen acceder.
Soporte
Las solicitudes de ayuda pueden multiplicarse aunque los servidores funcionen. El equipo necesita conocer el alcance real de la interrupción.
Compromisos de disponibilidad
Una caída del enrutamiento puede activar obligaciones del SLA incluso si los sistemas internos siguen operativos.
Confianza del cliente
El cliente rara vez distingue entre una ruta fallida y un servidor averiado. Recuerda que el servicio no estuvo disponible.
Coste de respuesta
La recuperación puede implicar a ingenieros, proveedores de tránsito, operadores externos, seguridad, responsables del registro y de RPKI, soporte y dirección. Los recursos numéricos deben formar parte del plan general de continuidad.
Cómo comprobar si falla el enrutamiento
Antes de culpar a la aplicación, examine visibilidad, origen, validación y cambios recientes.
¿Sigue visible el prefijo?
Consulte distintas vistas del enrutamiento mundial. Si desapareció, investigue la ausencia o retirada del anuncio BGP.
¿Qué ASN lo está originando?
Compare el observado con el esperado. Una diferencia puede señalar configuración errónea, migración incompleta, secuestro o autorización desactualizada.
¿Cuál es el estado RPKI?
Compruebe Valid, Invalid o Not Found. Si un cambio legítimo provoca Invalid, revise la ROA; el estado, por sí solo, no prueba un ataque.
¿Hay prefijos más específicos inesperados?
Una ruta más específica puede atraer tráfico del agregado. Revise también los subprefijos, no solo el bloque principal.
¿Qué se modificó antes del incidente?
Revise cambios en routers, proveedores, ASN, RPKI, filtros, infraestructura y registro. La secuencia temporal ayuda a localizar la causa.
¿Los datos reflejan la producción?
Contraste registro e IRR con la red verificada. Consultar una sola capa deja puntos ciegos.
Ocho pasos para recuperar el servicio
Una respuesta ordenada define primero el estado esperado, compara observaciones, comprueba autorizaciones y filtros, corrige la causa y confirma la recuperación.
1. Establecer la referencia
Documente prefijo afectado, ASN esperado, proveedor de salida, anuncio previsto, ROA vigente y objeto IRR. Sin esa referencia no puede identificar bien la desviación.
2. Comparar varias perspectivas
No se limite al router local. Distintas redes y regiones ayudan a distinguir un fallo local, del proveedor, regional o de propagación amplia.
3. Comprobar RPKI
Revise prefijo, ASN, longitud máxima, vigencia del certificado y validación del objeto firmado. Si cambió la arquitectura, compruebe que la ROA acompañó al cambio.
La carga de una ROA no contiene un campo independiente de «periodo de autorización». La caducidad o revocación del certificado puede invalidar el objeto; el estado de la ruta depende después de los datos validados restantes. Perder una ROA no convierte automáticamente toda ruta afectada en Invalid.
4. Revisar IRR y filtros
Los filtros del proveedor deben permitir los anuncios legítimos previstos para el cliente, especialmente después de migraciones.
5. Contactar con información concreta
Facilite prefijo, ASN esperado y observado, estado RPKI, hora del incidente y evidencias de rutas. Estos datos permiten actuar con más rapidez que un aviso genérico.
6. Corregir el origen del error
Si el fallo está dentro de su red, ajuste la configuración y compruebe que el anuncio correcto se propaga.
7. Proteger el servicio durante una disputa
Conserve el último estado verificado, información de seguridad, historial del registro y pruebas. Un conflicto de control debe resolverse sin desestabilizar innecesariamente la producción ni a los clientes.
8. Vigilar la recuperación
Los cambios no llegan a todas partes a la vez. Continúe observando hasta que la ruta prevista sea visible y la conectividad de los clientes se estabilice.
Reducir la probabilidad y el impacto
Ninguna red puede evitar todos los incidentes. Sí puede coordinar mantenimiento de autorizaciones, filtros, registros y vigilancia.
Actualizar las ROA
Revise las autorizaciones al cambiar ASN de origen, proveedor, longitud del prefijo o arquitectura.
Incorporar validación del origen
Las redes receptoras pueden incluir ROV en su política BGP. Establecer el estado y decidir qué hacer con la ruta son operaciones diferentes.
Mantener los objetos IRR
Los datos deben reflejar las declaraciones legítimas previstas; atender los objetos antiguos forma parte del mismo trabajo que crear los nuevos.
Limitar lo que puede anunciar cada vecino
Un vecino BGP no debe poder anunciar cualquier ruta por defecto. Los filtros reducen la propagación de errores.
Detectar cambios de rutas
Vigile prefijos ausentes, nuevos ASN de origen, subprefijos inesperados, cambios RPKI y AS paths anómalos. Detectar antes reduce la duración del incidente.
Mantener datos y contactos
La información de la organización, sus responsables y sus recursos debe permitir encontrar a la persona adecuada durante una incidencia.
Auditar recursos y dependencias
Incluya IPv4, IPv6, ASN, BGP, RPKI, IRR, acceso al registro, contactos, contratos y dependencias de red. La revisión periódica debe abarcar el conjunto, no solo las direcciones.
Una salida para el propio recurso
NRS defiende que una red activa no quede ligada para siempre a un único guardián institucional. Fallos, insolvencia, indisponibilidad técnica, conflictos de gobierno, impedimentos legales o pérdida de confianza deberían dejar una vía de continuidad.
La portabilidad del recurso no exige trasladar toda la empresa. Busca poder cambiar de proveedor administrativo conservando pruebas de control, registros, DNS inverso, RPKI, rutas e historial de auditoría.
Esta portabilidad y la continuidad mediante un registro sucesor son propuestas de resiliencia. Su disponibilidad depende de los mecanismos aplicables: el artículo no promete que cualquier recurso pueda trasladarse o cambiar de administrador hoy. Sin salida, un fallo institucional puede convertirse en un fallo de red.
La función de registro debe sobrevivir a la institución
La infraestructura crítica no debería depender por completo de la supervivencia de una sola entidad. Su continuidad debe contemplar copias del estado del registro, historial, WHOIS/RDAP, DNS inverso, repositorios RPKI, credenciales, transferencias, información sobre disputas y administración sucesora.
Proteger esa función no exige preservar cada junta, norma, interpretación contractual o poder del operador actual. Exige mantener las funciones técnicas que Internet necesita.
Proteger los registros, no un control ilimitado
La unicidad de las direcciones, datos exactos, declaraciones de seguridad disponibles y disputas documentadas requieren coordinación fiable. Pero la entidad que mantiene el registro no es el registro mismo.
Si falla, la prioridad deben ser los datos, la cadena de seguridad, las rutas, los clientes y la red activa. Cuanto más crítica sea la coordinación, más auditable, sustituible y resiliente debe ser su operador, y más portables sus recursos.
Dar prioridad a la red que funciona
El principio de «Running-Code Primacy» que plantea NRS centra la coordinación común en lo necesario para la interoperabilidad: unicidad, registros exactos, prueba de control, seguridad, transferencias, información de conflictos y continuidad.
Eso no otorga automáticamente al registro autoridad sobre modelos comerciales, ubicación de clientes, alquiler, financiación de activos, estrategia o todos los usos futuros. Contratos, leyes, mercados, operadores y otros mecanismos adecuados pueden ocuparse de esas cuestiones.
Sin una amenaza técnica real a la unicidad o interoperabilidad, esas diferencias no deberían convertirse en fallos de enrutamiento. Delimitar la función del registro fortalece la red.
La estabilidad debe medirse en acceso real
Una institución puede seguir atendiendo en su oficina mientras los clientes están desconectados. A la inversa, un problema de gobierno no significa necesariamente que las redes hayan dejado de funcionar.
Lo relevante es si las redes legítimas siguen operando, los clientes son accesibles, las rutas se propagan, las declaraciones válidas permanecen disponibles y los conflictos se resuelven sin destruir producción. Esa continuidad es la que debe proteger la gobernanza.
Preparar un plan para los recursos numéricos
Las empresas planifican fallos de electricidad, centros de datos, nube, tránsito, equipos, personal y ciberseguridad. Los recursos numéricos merecen el mismo trato.
¿Qué ocurre si desaparece un prefijo? ¿Quién modifica la ROA y conserva las credenciales RIR? ¿Qué ASN anuncia cada bloque? ¿Qué clientes necesitan direcciones fijas y qué aplicaciones dependen de los rangos? ¿Quién contacta al proveedor? ¿Qué pruebas acreditan control? ¿Qué pasa si el registro deja de estar disponible, necesita relevo o surge una disputa? Estas respuestas deben estar preparadas antes del incidente.
IP y ASN forman parte del negocio
Clientes, API, DNS, cortafuegos, VPN, listas de acceso de socios, nube, políticas de seguridad, pagos, monitorización y documentación de cumplimiento pueden depender de los identificadores de red.
Que los servidores, la aplicación y la alimentación funcionen no basta si el prefijo no puede enrutarse correctamente. La continuidad de los recursos pertenece al plan de continuidad empresarial.
El objetivo es que Internet siga funcionando
Errores BGP, fugas, secuestros, filtros incorrectos, ROA o IRR obsoletos, registros inexactos y divergencias administrativas pueden dejar un servicio inaccesible.
La protección va más allá de los routers: red activa, recursos, autorizaciones, registros, seguridad y control deben seguir siendo coherentes. Los registros preservan unicidad; RPKI protege el enrutamiento; las disputas se separan; la portabilidad ofrece salida, y el relevo mantiene funciones críticas.
El fin no es la inmortalidad de una institución. Es la continuidad de Internet. Proteger clientes, red, declaraciones de seguridad y registros exige distinguir al guardián de la infraestructura a la que debe servir.
Preguntas frecuentes
¿Qué suele causar problemas de enrutamiento?
Errores BGP, fugas, anuncios no autorizados, filtros incorrectos, problemas RPKI o ROA, fallos del proveedor e incoherencias entre rutas y registros.
¿Qué es una fuga BGP?
La propagación de información de rutas más allá del ámbito previsto por la política, que puede atraer tráfico a un camino no deseado.
¿Qué es un secuestro BGP?
Un ASN origina un prefijo sin autorización legítima. Si otros aceptan el anuncio, el tráfico puede desviarse.
¿Qué aporta RPKI?
Información verificable criptográficamente para evaluar si un ASN está autorizado a originar un prefijo. ROV no certifica el camino completo.
¿Una ROA incorrecta puede interrumpir el servicio?
Sí. Una ruta legítima puede resultar Invalid si existen datos validados que la cubren pero ninguno permite su ASN y longitud. Algunas redes la rechazarán según su política. La caducidad de un certificado o el descarte de un objeto es diferente: el estado final depende de los datos validados restantes.
Fuentes
Publicado el 11 de agosto de 2026 y actualizado el 13 de agosto. La validez del certificado y del objeto firmado es distinta del estado de validación de la ruta. La portabilidad, continuidad y administración sucesora son propuestas de NRS, no servicios de disponibilidad general garantizada.
Incluir los recursos en la próxima revisión de continuidad
NRS Shield es donde los operadores convierten el riesgo individual en fuerza colectiva, y el poder es la forma de dar a NRS la autoridad para actuar por tu red.